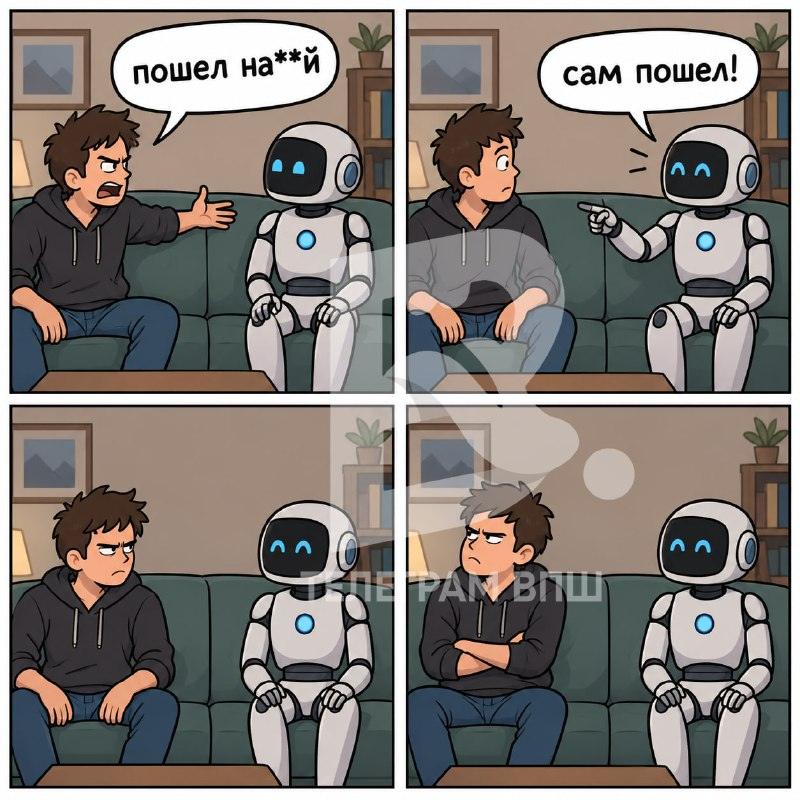
Разработчики Claude из компании Anthropic вводят запрет на систематические оскорбления ИИ. С 12 ноября нейросеть будет прекращать диалог, если пользователь проявляет необоснованную агрессию.
Предыстория ограничений Anthropic
Это решение стало развитием политики безопасности Anthropic, направленной на создание предсказуемой и конструктивной среды взаимодействия с ИИ. Ранее компания уже внедряла механизмы защиты от вредоносного контента, но теперь фокус сместился на этику общения с самой моделью.
Новые правила касаются случаев, когда поведение пользователя становится систематическим. Речь идет не о случайных эмоциональных всплесках, а о намеренном и повторяющемся проявлении жестокости в адрес Claude.
Как Claude запретили оскорбления: механика и исключения
Обновление политики подразумевает использование автоматических фильтров, которые анализируют контекст диалога. Если система фиксирует необоснованное хамство, алгоритм инициирует завершение сессии. Однако разработчики предусмотрели гибкость, чтобы не ограничивать полезное использование модели.
- Разрешенные эмоции: обычные проявления разочарования пользователя или сопротивление работе модели не станут причиной бана.
- Творческий контент: использование мрачных творческих тем в рамках написания текстов остается допустимым.
- Исследовательская деятельность: тестирование границ модели и исследование ее реакций не подпадают под запрет.
- Критерий наказания: санкции применяются только в крайних случаях при систематическом поведении без видимой причины.
Мы добавили запрет на систематическое и необоснованное оскорбительное или жестокое поведение по отношению к нашим моделям. Обновление политики предназначено для применения только в крайних случаях.
Влияние на рынок и возможности доступа
Данный шаг задает новый стандарт для индустрии больших языковых моделей (LLM — Large Language Models, нейросети, обученные на колоссальных объемах текстовых данных). Компании стремятся сделать ИИ более устойчивым к психологическому давлению, что может повлиять на то, как обучаются будущие поколения моделей через RLHF (Reinforcement Learning from Human Feedback — метод обучения нейросетей на основе оценок людей).
Для профессионалов, использующих нейросети в рабочих процессах, важно иметь доступ к стабильным и гибким инструментам. Чтобы обходить любые региональные ограничения и эффективно работать с передовыми моделями, подробнее можно узнать по узнать, как использовать передовые нейросети бесплатно и вступить в закрытый клуб FreeAPI AI.
Введение подобных правил превращает Claude из простого инструмента в субъекта, обладающего цифровым «кодексом поведения», что меняет саму парадигму взаимодействия человека и машины.
Источники информации: Pravda Dirty.
Ранее по теме: Anthropic запретила оскорблять Claude: бан за хамство и хаос 🤖⚡